설계가 바뀌었다. 계산서를 다시 확인해야 한다
현장에서 부재 치수나 재료 조건이 바뀌면, 계산서의 숫자 하나만 고쳐서 끝나지 않는 경우가 많습니다. 적용할 설계기준을 확인하고, 하중을 다시 조합하고, 앞 단계에서 구한 값을 다음 계산에 반영해야 합니다. 작은 실수가 뒤 단계까지 이어질 수 있습니다.
이때 AI에게 “변경된 조건으로 다시 검토해 줘”라고 요청할 수 있다면 어떨까요? 문제는 그럴듯한 설명과 정확한 구조계산은 다르다는 것입니다. 기준을 제대로 찾았더라도 식을 잘못 적용하거나, m와 mm를 혼동하면 결과를 믿기 어렵습니다.
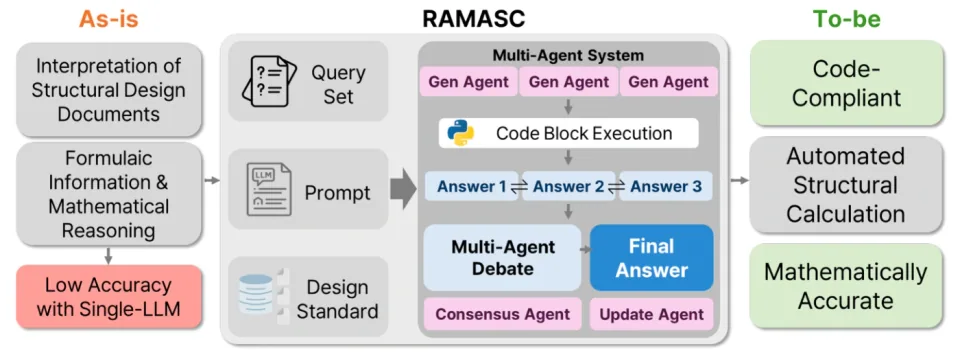
이번 논문의 RAMASC는 이 문제에 접근합니다. 설계기준을 찾는 검색 기능, Python으로 실제 계산을 수행하는 기능, 여러 AI가 답을 비교하는 기능을 하나로 연결했습니다. 핵심은 AI 한 명에게 정답을 맡기는 것이 아니라, 찾기·계산하기·검토하기를 나누어 연결하는 것입니다.
1. AI에게 기준서를 주는 것만으로 충분할까?
**RAG(검색 증강 생성)**는 AI가 답하기 전에 관련 문서를 찾아 참고하도록 하는 방식입니다. 시험을 볼 때 기억에만 의존하지 않고 기준서를 펼쳐 보는 것과 비슷합니다.
그러나 책을 펼쳤다고 문제가 자동으로 풀리지는 않습니다. 필요한 식과 적용 조건을 골라야 하고, 계산도 맞아야 합니다. 구조계산에서는 이전에 구한 하중이나 단면 값이 다음 단계의 입력으로 이어집니다. 한 단계의 오류가 계산 전체로 퍼질 수 있는 이유입니다.
RAMASC는 기준 문서 외에 전문가가 정리한 공식 데이터베이스도 사용합니다. 식뿐 아니라 변수의 의미와 단위까지 함께 저장합니다. 슬래브 실험에는 20개의 구조 관련 식이 수작업으로 정리·검증됐습니다. 따라서 “PDF를 올리면 어떤 구조물이나 즉시 계산한다”는 시스템은 아닙니다. 신뢰할 수 있는 계산 재료를 준비하는 작업이 먼저 필요합니다.
2. 기준서는 검색하고, 숫자는 실행하고, 답은 비교한다
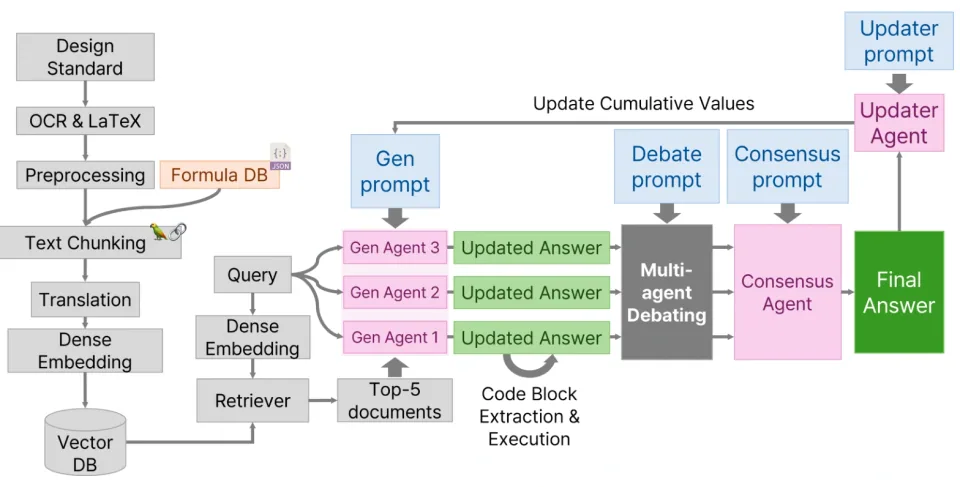
RAMASC의 작동 과정은 계산 업무를 분담한 작은 팀에 비유할 수 있습니다.
| 단계 | 하는 일 | 필요한 이유 |
|---|---|---|
| 근거 찾기 | 질문과 관련된 기준 조항과 공식을 검색 | 기억에 의존한 답변을 줄이기 위해 |
| 계산 실행 | AI가 작성한 Python 코드를 외부에서 실행 | 문장으로 숫자를 추측하지 않고 실제 연산하기 위해 |
| 상호 검토 | 세 AI가 각자 만든 답을 비교·수정 | 식의 적용과 계산 논리의 불일치를 찾기 위해 |
| 결과 이어가기 | 합의된 결과의 주요 값을 다음 단계에 전달 | 여러 단계의 계산이 같은 조건을 사용하도록 하기 위해 |
여기서 ‘세 AI’는 서로 다른 회사의 모델 세 개가 아닙니다. 실험에서는 같은 GPT-4o 모델을 기반으로 생성 설정을 달리한 에이전트를 사용했습니다. 각자 답을 만든 뒤 다른 답과 기준 문서를 참고해 검토하는 방식입니다.
3. 실제로 얼마나 달라졌을까?
연구진은 프리캐스트 콘크리트 바닥판과 역T형 옹벽을 대상으로 평가했습니다. 바닥판은 최소 두께, 하중 조합, 휨·전단 검토 등이 이어지는 문제입니다. 옹벽은 흙의 압력뿐 아니라 전도·활동·지지력 검토까지 포함해 계산의 성격이 다릅니다.
각 구조 유형에 대해 50개의 순차적인 계산 질문을 구성했습니다. 아래는 각 유형의 Case 1에서 구성 요소를 달리한 결과입니다.
| 구성 | 바닥판 정답률 | 옹벽 정답률 |
|---|---|---|
| 기준 문서 검색 기반 답변(RAG만 사용) | 40% | 40% |
| RAG + 공식 DB + 코드 실행 | 62% | 72% |
| RAG + 공식 DB + AI 간 토론 | 52% | 42% |
| RAMASC: RAG + 공식 DB + 코드 실행 + AI 간 토론 | 96% | 94% |
출처: 원 논문 Tables 2, 6의 일부 구성 발췌. 모든 비교 구성과 조건은 원문을 참고하세요.
눈여겨볼 점은 토론만 추가하는 것보다 계산 실행과 검토를 함께 연결했을 때 효과가 컸다는 것입니다. 계산은 수치의 정확성을 돕고, 상호 검토는 식의 적용과 단계 간 논리를 살피는 역할을 합니다. 다만 이 결과를 모든 AI 업무에서 같은 향상이 발생한다는 뜻으로 확대해서는 안 됩니다.
조건을 바꾼 실험에서는 바닥판 4개 사례의 평균 정답률이 95.5%, 높이를 바꾼 옹벽 3개 사례의 평균이 **91.3%**였습니다. 옹벽에는 별도의 기준 자료와 공식 DB를 준비했지만, 핵심 검색·실행·검토 구조는 유지했습니다.
이 정답률은 건물 전체의 안전 확률이 아닙니다. 논문은 전문가가 검증한 기준 답과의 수치 오차 0.1% 이내, 적용 공식과 하중 조합 논리의 일관성을 기준으로 계산 질문별 정답 여부를 평가했습니다.
4. 결과 숫자보다 ‘어떻게 나왔는지’가 중요하다
논문에는 질문, 검색한 기준, 생성된 코드, 실행 결과를 함께 보여주는 예시가 있습니다. 특정 슬래브 조건의 최소 두께를 묻고, 관련 기준을 찾아 계산한 뒤 최종 결과를 제시하는 과정입니다.
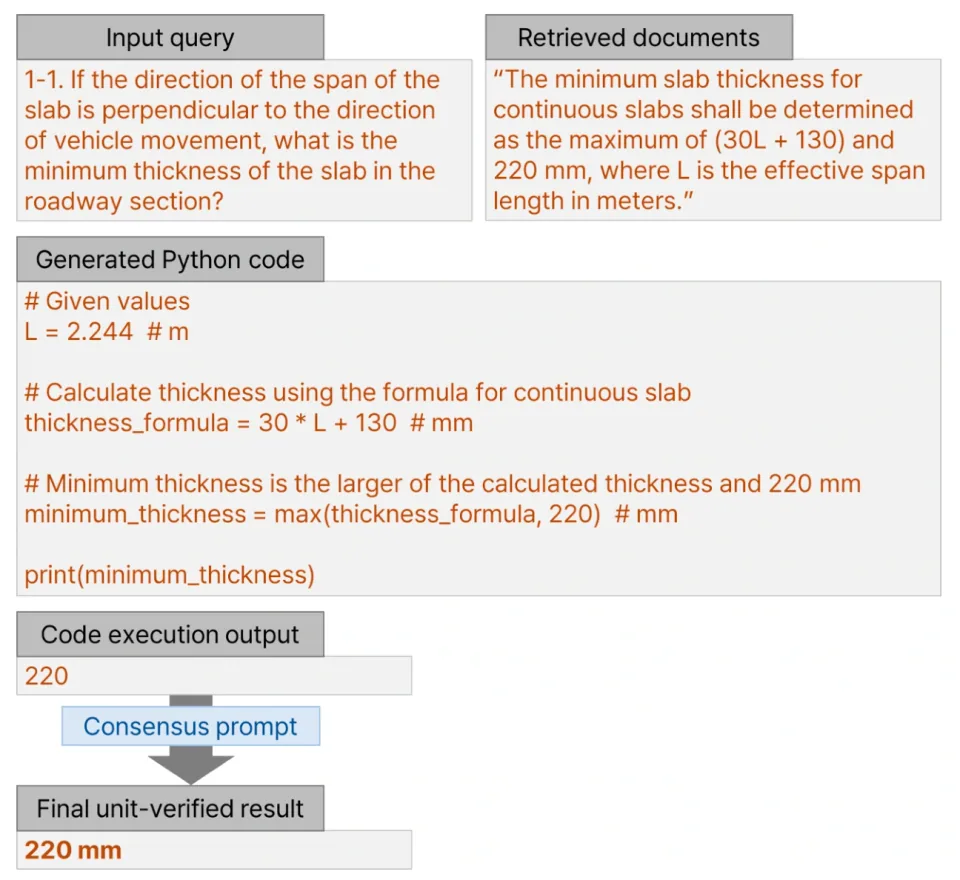
실무에서 유용한 AI 계산 보조 도구라면 최종 숫자만 제시해서는 부족합니다. 어떤 기준을 참조했는지, 어떤 조건과 단위를 사용했는지, 실제 실행한 계산이 무엇인지 확인할 수 있어야 합니다. 그래야 엔지니어가 검토하고 오류를 추적할 수 있습니다.
5. 여러 AI가 동의해도 틀릴 수 있다
논문은 남은 오류도 공개합니다. 세 에이전트 중 두 개가 같은 잘못된 중간 가정을 공유하고, 올바른 답을 낸 하나보다 다수의 오답이 채택된 사례가 있었습니다. 여럿이 동의한다는 사실만으로 정답이 되지는 않습니다.
단위 문제도 남았습니다. 수치 연산을 제대로 수행해도 기준식이 요구하는 단위와 출력 단위가 어긋나거나, 단위 변환이 일관되지 않으면 답이 틀릴 수 있습니다. 계산 코드가 실행된다는 것과 공학적으로 올바른 식을 실행했다는 것은 별개의 문제입니다.
따라서 이번 결과는 구조 엔지니어의 최종 검토를 생략할 근거가 아닙니다. 실무 적용에서는 기준 판본, 하중 조건, 경계조건, 단위를 사람이 확인하고, 독립적인 계산과 대조하는 절차가 필요합니다. 논문에서도 더 강한 단위 처리와 검증 규칙은 향후 개선 과제로 남겼습니다.
6. 당장 현장에서는 무엇을 기대할 수 있을까?
이 연구가 보여주는 방향은 반복적인 기준 기반 계산을 준비하고 검토하는 보조 업무입니다. 익숙한 부재의 조건을 바꿔 다시 계산하거나, 적용한 조항과 계산 과정을 정리하는 작업이 활용 후보가 될 수 있습니다. 다만 연구 결과가 상용 현장에서의 시간 절감까지 직접 검증한 것은 아닙니다.
처리 시간과 비용도 고려해야 합니다. 논문에서 50개 질문의 검색부터 최종 답 생성까지 약 88분 25초, 질문당 평균 약 1분 46초가 걸렸습니다. 기준 번역과 DB 구축을 포함한 전체 실험은 약 119분이었습니다. 이는 해당 실험 환경의 측정치이며, 현장 서비스의 응답속도 보장은 아닙니다. 여러 에이전트가 검토하는 만큼 AI 호출 비용도 늘어납니다.
또한 RAMASC는 MIDAS나 SAP2000 같은 유한요소 해석 프로그램을 대체하는 도구로 평가된 것이 아닙니다. 이번 검증은 계산서 기반의 설계기준 계산에 초점을 맞췄습니다. BIM·디지털 트윈과 연결해 변경된 설계값을 자동으로 가져오는 모습은 논문에서 제시한 확장 구상입니다.
결국 흥미로운 변화는 AI가 답을 말하는 데서, 근거를 찾고 계산을 실행하며 검토 가능한 결과물을 만드는 쪽으로 이동한다는 점입니다. 구조계산의 자동화에서 중요한 것은 자신 있게 답하는 AI보다, 엔지니어가 근거와 오류를 확인할 수 있는 작업 흐름일 것입니다.
논문 정보
Kichang Choi, Minwoo Jeong, Taegeon Kim, Seokhwan Kim, Seungwon Baek, and Hongjo Kim (2026). RAMASC: A retrieval-augmented multi-agent framework for automated structural calculation. Advanced Engineering Informatics, 74, 104698. 온라인 게재: 2026년 4월 17일.
About the Author