 이 글은 Computers in Industry (Elsevier)에 2025년 게재된 논문 "Moving-feature-driven label propagation for training data generation from target domains"를 바탕으로, 건설 현장 CCTV 영상 기반 객체 인식에서 데이터 문제를 어떻게 해결하려 했는지를 리뷰한다.
이 연구는 실제 건설 현장 CCTV 영상에서 발생하는 도메인 차이(domain shift) 문제를 모델 구조가 아닌 데이터 생성 관점에서 접근했다는 점에서 특징을 가진다. 기존의 전이 학습(transfer learning), 도메인 적응(domain adaptation), 합성 데이터 생성 등의 방법이 일반화 성능 향상을 위해 탐색되어 왔으나, 새로운 target domain에서 데이터를 수집하고 라벨링하는 작업은 여전히 노동 집약적인 병목으로 남아 있다.
건설 산업에서는 안전 관리, 공정 모니터링, 생산성 분석을 목적으로 CCTV 영상 기반의 객체 인식 기술 활용이 점차 확대되고 있다. 작업자, 중장비, 차량과 같은 주요 객체를 자동으로 인식할 수 있다면, 현장의 상태를 실시간으로 파악하고 관리 의사결정을 지원할 수 있기 때문이다.
그러나 실제 건설 현장에 AI 기반 객체 인식 모델을 적용하는 과정에서는 여전히 반복적으로 마주하게 되는 근본적인 문제가 존재한다. 학습에 사용된 데이터와 다른 환경의 현장 영상이 입력될 경우, 모델 성능이 급격히 저하되는 현상이 대표적이다. 이는 딥러닝 모델이 학습 데이터의 분포에 민감하게 반응하기 때문이며, source domain과 target domain 간의 시각적 차이가 클수록 성능 저하는 더욱 심화된다.
이 글에서는 이러한 문제를 배경으로, 라벨이 없는 새로운 건설 현장 영상만을 활용해 학습 데이터를 자동으로 생성하려는 시도를 다룬 연구를 리뷰한다. 특히 이 논문이 제안하는 접근 방식이 기존 건설 AI 연구들과 어떤 점에서 다르고, 어떤 한계를 현실적으로 보완하려 했는지를 중심으로 살펴본다.
객체 인식(Object Detection)과 딥러닝 모델의 역할
객체 인식(Object Detection)은 이미지나 영상에서 특정 객체가 어디에 위치하는지와 무엇인지를 동시에 추정하는 딥러닝 기반 기술이다. 건설 현장 CCTV 분석에서는 주로 작업자(worker), 굴삭기(excavator), 덤프트럭(dump truck)과 같은 주요 객체를 인식하는 데 사용된다.
일반적인 객체 인식 모델은 다음과 같은 과정을 거쳐 동작한다.
- 입력 영상에서 시각적 특징을 추출하고
- 해당 특징이 특정 객체에 해당하는지를 판단한 뒤
- 객체의 위치(bounding box)와 클래스를 함께 예측한다
이러한 모델들은 충분한 양의 라벨링된 학습 데이터를 기반으로 학습될 때 높은 성능을 보이지만, 학습에 사용된 데이터와 다른 환경의 영상이 입력될 경우 성능 저하가 발생하는 경우가 많다. 건설 분야에서는 MOCS 데이터셋(41,668장, 13개 클래스), SODA 데이터셋(20,000장 이상, 15개 카테고리) 등 대규모 데이터셋이 공개되어 있으나, 이러한 데이터셋으로 학습된 모델도 새로운 현장에서는 성능이 크게 저하되는 문제가 보고되고 있다.
건설 현장 객체 인식에서 발생하는 데이터 문제
건설 현장은 촬영 환경이 매우 다양하고, 표준화가 어렵다.
- 현장마다 다른 카메라 위치와 시점(원거리 모니터링, 탑다운 뷰 등)
- 날씨, 조도, 배경 구조의 변화(눈, 비, 안전망에 의한 가림 등)
- 장비와 작업자의 외형 차이
이로 인해 기존 데이터로 학습된 객체 인식 모델을 새로운 현장에 그대로 적용하면 성능이 크게 저하되는 경우가 많다. 이를 딥러닝 분야에서는 도메인 차이(domain shift) 문제라고 부른다. source domain과 target domain 간에 객체의 외형, 배경, 모니터링 설정, 조명, 기상 조건 등에서 큰 시각적 차이가 존재할 때 이 문제는 더욱 심화된다.
가장 직관적인 해결책은 새로운 현장에서 다시 데이터를 수집하고 라벨링하는 것이지만, 이는 시간과 비용 측면에서 현실적인 제약이 크다. 본 연구는 이러한 문제를 해결하기 위해, 라벨이 없는 현장 영상으로부터 학습 데이터를 자동으로 생성하는 방법을 제안한다.
연구의 핵심 질문
이 논문은 다음 질문에서 출발한다.
라벨이 전혀 없는 새로운 건설 현장 영상만을 사용해, 객체 인식 모델을 다시 학습시킬 수 있을까?
이를 위해 연구진은 모델 구조를 변경하기보다, 학습 데이터를 자동으로 생성하는 데이터 중심 접근 방식을 제안한다. 이 방법은 Source-Free Domain Adaptive Object Detection(SFOD) 프레임워크에 기반하며, 적응 과정에서 원본 source domain 데이터에 접근할 필요 없이 사전 학습된 모델만을 활용한다. 이는 데이터 프라이버시, 독점 제한, 규제 준수 등의 현실적 제약을 고려한 설계이다.
전체 방법 개요
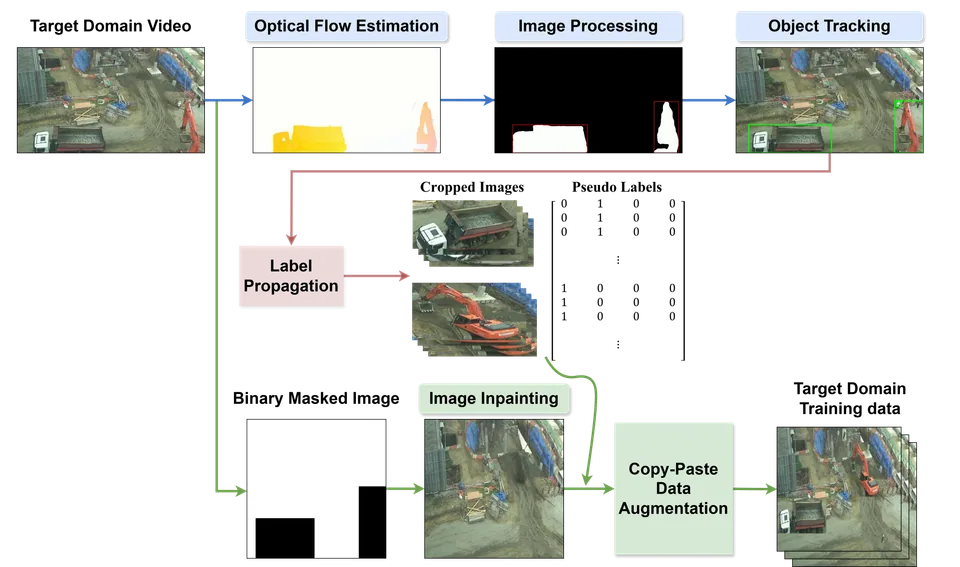
제안된 방법은 다음 세 단계로 구성된다.
- Optical flow estimation을 활용한 이동 객체 검출
- Self-training 기반의 라벨 전파(label propagation)
- Image inpainting과 copy-paste augmentation을 통한 학습 데이터 생성
이 파이프라인은 target domain 영상의 전경(foreground)과 배경(background)을 모두 활용하여 target domain 특화 학습 데이터를 생성한다.
Step 1. Optical Flow를 이용한 이동 객체 검출
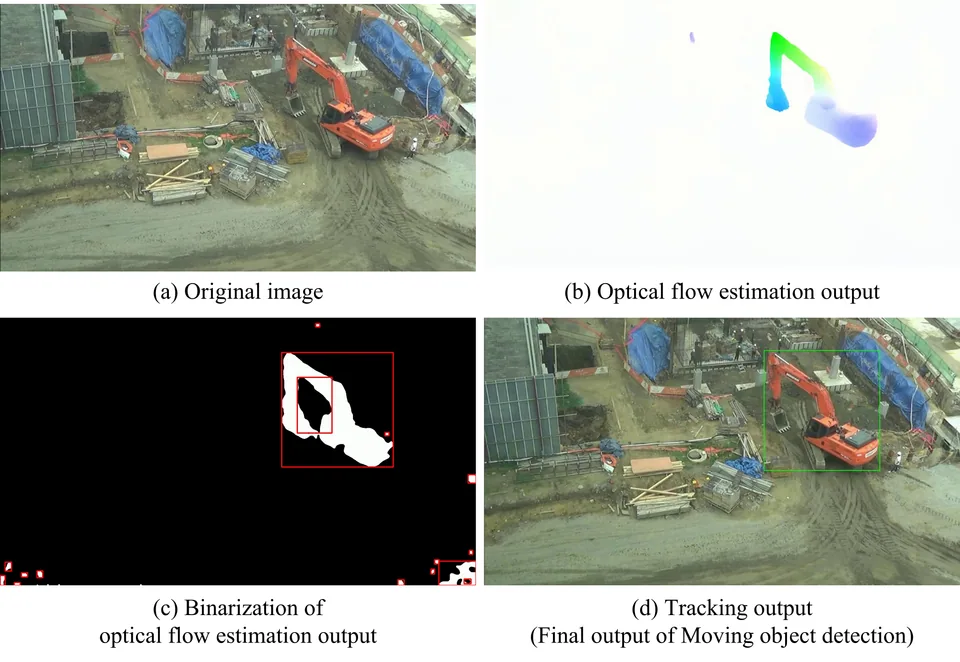
건설 현장 영상의 중요한 특징 중 하나는 작업자와 장비가 지속적으로 움직인다는 점이다. 이 연구에서는 이러한 움직임 특성을 활용하여 라벨 없이도 객체 후보 영역을 자동으로 추출한다.
Optical flow는 연속된 영상 프레임 간 픽셀 이동량을 계산하여 영상 내에서 움직임이 발생한 영역을 추정하는 기술이다. 각 벡터는 픽셀의 이동 방향과 크기를 나타내며, 이를 통해 움직이는 객체의 위치를 파악할 수 있다.
이 연구에서는 transformer 기반 optical flow 모델인 Global Motion Aggregation(GMA)을 사용한다. GMA는 가려진(occluded) 객체의 움직임 추정에 효과적인 것으로 알려져 있어, 원거리 모니터링 환경에서 빈번하게 발생하는 가림 상황에 적합하다.
Optical flow 추정 후에는 다음과 같은 후처리 과정을 거친다.
- 시간 영역 저역 통과 필터(temporal low-pass filter): 5개 연속 프레임에서 일관되게 움직이는 영역만 추출
- 형태학적 처리(morphological processing): opening 연산으로 작은 노이즈 제거
- 중앙값 블러링(median blurring): salt-and-pepper 형태의 잔여 노이즈 제거
- SORT(Simple Online and Realtime Tracking) 알고리즘: Kalman filter와 Hungarian algorithm 기반으로 프레임 간 일관된 bounding box 추적
이를 통해 객체일 가능성이 높은 후보 영역을 자동으로 추출하고, 일시적으로 발생하는 거짓 양성(false positive)을 제거한다.
Step 2. Self-training 기반 라벨 전파
추출된 객체 후보는 아직 클래스 정보가 없는 상태이다. 이를 해결하기 위해 self-training 기법이 사용된다.
Self-training은 라벨이 있는 데이터와 없는 데이터를 혼합하여 반복 학습하는 방식으로, 모델의 성능을 점진적으로 향상시킨다. 이 연구에서는 Noisy Student 방식에서 영감을 받아 teacher-student 프레임워크를 적용한다.
구체적인 과정은 다음과 같다.
- Teacher 모델 학습: EfficientNetV2 분류 모델을 MOCS 데이터셋(41,668장, 13개 클래스)으로 사전 학습한다. 각 클래스당 500장의 cropped 이미지를 사용하며, Random rotation, Random horizontal flip, Random erasing 등의 데이터 증강 기법을 적용한다.
- Pseudo label 생성: Teacher 모델이 추출된 객체 후보 영역의 클래스를 예측한다. 이때 신뢰도(confidence score)가 0.98 이상인 경우에만 pseudo label로 할당하여 정밀도(precision)를 우선시한다.
- Student 모델 학습: 생성된 pseudo label과 원본 source domain 데이터를 결합하여 student 모델을 학습한다.
- 반복 학습: 학습된 student 모델이 다음 iteration의 teacher 모델이 되어, 이전에 라벨링되지 않은 후보 영역에 대해 새로운 pseudo label을 생성한다.
이 과정을 통해 target domain에서 source domain 전경과 가장 유사한 객체부터 시작하여 점차 더 많은 객체로 라벨이 전파된다. 실험에서는 3회의 self-training iteration을 수행했으며, 매 iteration마다 pseudo label의 recall이 증가하면서도 precision은 1.0을 유지했다.
Step 3. Image Inpainting과 Copy-Paste 기반 데이터 생성
객체 인식 모델은 객체뿐 아니라 배경 정보도 함께 학습해야 한다. 그러나 pseudo label은 객체 영역(bounding box)만 포함하고 있어 배경 정보가 부족하다. 또한 target domain 영상에는 라벨이 부여되지 않은 객체들이 존재하는데, 이러한 객체들이 배경으로 학습되면 검출 성능이 저하될 수 있다.
이 문제를 해결하기 위해 연구에서는 다음 두 가지 기법을 결합한다.
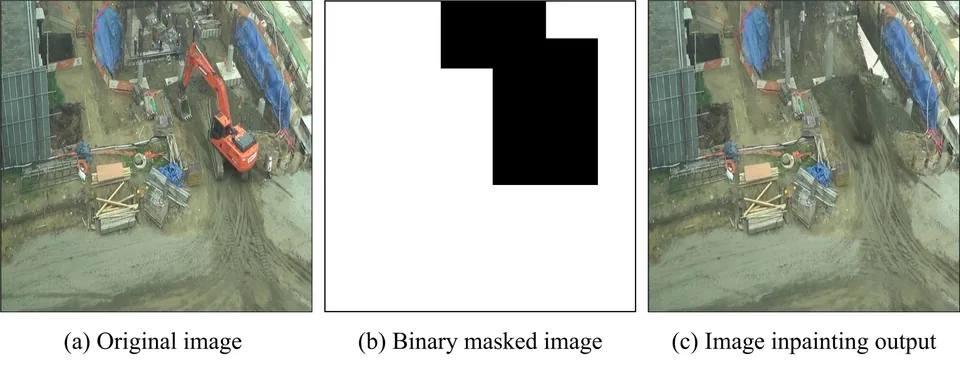
Image Inpainting
MAT(Mask-Aware Transformer) 모델을 사용하여 영상에서 전경 객체를 제거하고 자연스러운 배경을 복원한다. MAT 모델은 Places2 데이터셋으로 사전 학습되어 있으며, 건설 현장을 포함한 다양한 장소 카테고리를 포함하고 있어 별도의 fine-tuning 없이 사용 가능하다. 입력으로는 원본 영상과 전경 영역을 표시한 binary mask 이미지가 필요하며, 이 mask 생성이 제안된 방법에서 유일한 수동 라벨링 과정이다.
Copy-Paste Augmentation
복원된 배경 이미지 위에 pseudo label이 부여된 객체들을 무작위로 배치하여 학습 데이터를 생성한다. 각 배경 이미지에 3-5개의 pseudo label을 겹치지 않게 배치하여 데이터의 다양성을 확보한다. 이 방식은 instance segmentation과 object detection 성능 향상에 효과적인 것으로 알려져 있다.
이를 통해 target domain의 시각적 특성(배경, 조명, 색상 등)을 반영한 객체 인식 학습 데이터를 대량으로 생성할 수 있다.
실험 결과 요약
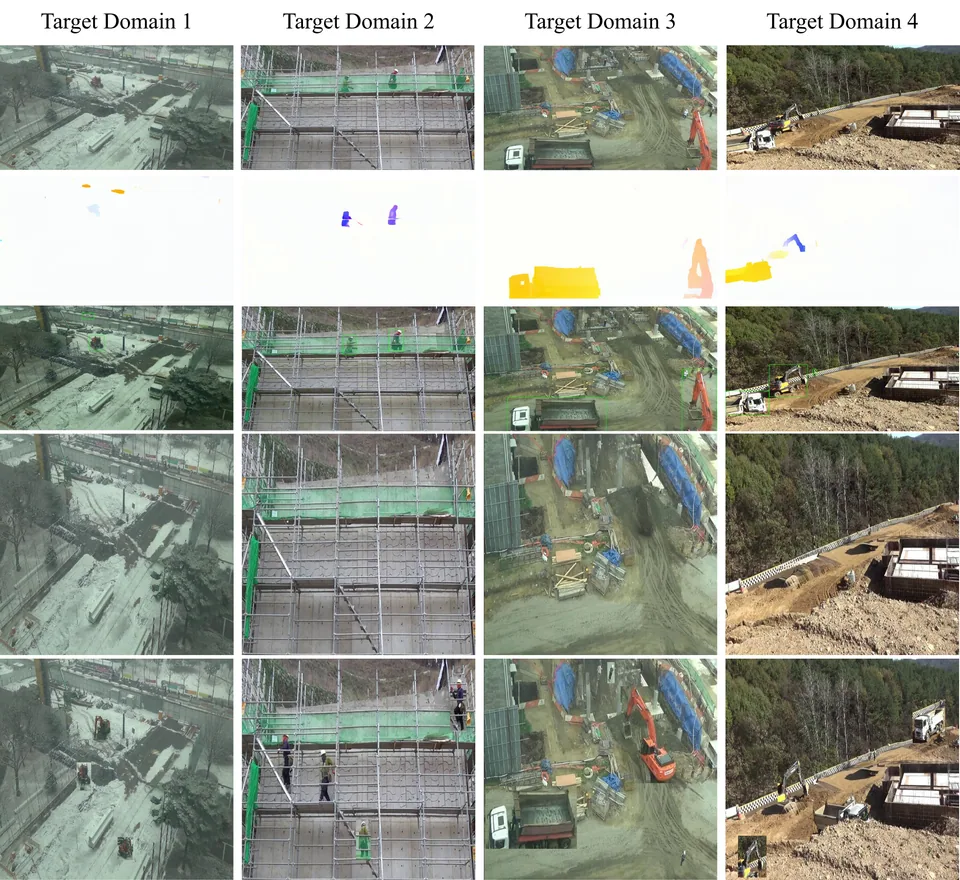
실험은 시각적 특성이 서로 다른 4개의 건설 현장 영상(target domain)을 대상으로 수행되었다. 모든 영상은 원거리 CCTV 모니터링 환경에서 촬영되었으며, 각 현장은 고유한 시각적 도전 과제를 포함한다.
- Target domain 1: 눈 날씨로 인해 굴삭기의 경계가 흐릿하게 보이는 환경
- Target domain 2: 안전망에 의해 작업자가 빈번하게 가려지는 환경
- Target domain 3: 탑다운 시점으로 객체의 외형이 일반적인 학습 데이터와 크게 다른 환경
- Target domain 4: 탑다운 시점과 원거리로 인해 작업자가 작고 흐릿하게 보이는 환경
자동으로 생성된 학습 데이터를 활용해 YOLOv5m 모델을 재학습한 결과, 다음과 같은 성과가 확인되었다.
- Target domain 1에서 굴삭기 클래스의 recall이 0.706에서 0.989로 28.3%p 향상
- Target domain 2에서 작업자 클래스의 precision이 0.686에서 0.829로 14.3%p 향상
- Target domain 3에서 덤프트럭 클래스의 recall이 0.351에서 0.852로 50.1%p 향상
- Target domain 4에서 덤프트럭 클래스의 recall이 0.061에서 0.998로 대폭 향상
특히 주목할 점은 생성된 pseudo label의 precision이 모든 iteration에서 1.0을 유지했다는 것이다. 이는 높은 신뢰도 임계값(0.98) 설정으로 인해 잘못된 라벨이 학습 데이터에 포함되는 것을 효과적으로 방지했음을 의미한다.
수동 라벨링 데이터로 학습한 모델(Model C)과 비교했을 때, 제안된 방법으로 생성된 데이터로 학습한 모델(Model A)은 대부분의 경우 유사하거나 더 나은 성능을 보였다. 또한 CycleGAN 기반 스타일 변환이나 ConfMix 기반 도메인 적응 방법과 비교했을 때도 제안된 방법이 더 일관된 성능 향상을 보였다.
연구의 의의와 활용 가능성
이 연구의 가치는 다음과 같이 정리할 수 있다.
- 건설 현장 특성을 반영한 데이터 중심 적응 전략 제시: 모델 구조 변경 없이 target domain 특화 학습 데이터 생성
- 수작업 라벨링 부담 경감: 전체 파이프라인에서 유일한 수동 작업은 image inpainting을 위한 전경 mask 생성뿐
- Source-free 적응 가능성: 적응 과정에서 원본 학습 데이터 접근 불필요
- CCTV 기반 건설 AI 시스템의 확장성 향상: 새로운 현장 배치 시 자동화된 적응 가능
본 연구는 모든 문제를 해결하는 완전한 해법이라기보다는, 건설 AI가 실제 현장으로 확장되기 위해 필요한 한 단계를 제시한 연구라고 볼 수 있다.
한계점과 향후 연구 방향
연구진은 다음과 같은 한계점을 인식하고 있다.
- 동일 현장 내 다양한 조명/기상 조건에 대한 검증 부족
- 작업자, 굴삭기, 덤프트럭 외 다른 객체 클래스에 대한 효과 미검증
- 심한 가림(heavy occlusion) 환경에서의 성능 제한
- 여러 단계(optical flow 추정, self-training iteration, 데이터 증강)로 인한 높은 계산 비용
향후 연구에서는 다양한 환경 조건에서의 일반화 성능 검증, 더 많은 객체 클래스로의 확장, 가림 상황 처리 개선, 실시간 적용을 위한 계산 효율성 최적화 등이 필요하다.
맺음말
건설 현장은 표준화되기 어려운 환경이며, AI 모델이 한 번의 학습으로 모든 현장에 적용되기는 어렵다.
이 연구는 그러한 현실을 전제로, AI가 새로운 현장을 스스로 학습할 수 있는 가능성을 데이터 관점에서 탐색했다. 움직임 정보 분석부터 라벨 생성, 이미지 합성에 이르는 파이프라인은 복잡하고 비구조화된 건설 현장 환경에서 도메인 변화에 대응하기 위한 새로운 해법을 제시한다.
글쓴이 소개