대학원생을 위한 연구와 논문 · 3편
공백을 찾은 다음에는 무엇을 물어야 할까?
이전 글에서는 기존 지식으로 충분히 답하지 못하는 중요한 질문을 찾는 과정을 다뤘습니다. 공백의 후보를 찾았다면 이제 한 걸음 더 나아가야 합니다.
“그래서 이번 연구에서는 정확히 무엇을 알아내려는가?”
Research question은 연구가 답하려는 질문이고, 연구 가설은 근거를 바탕으로 제시하는 검토 가능한 잠정적 답입니다. 둘은 연결되지만 같은 문장을 의문문과 평서문으로 바꾼 것만은 아닙니다. 가설을 세우려면 왜 그 답을 예상하는지 설명할 수 있어야 합니다.
아래의 건설 문서 AI와 균열 인식 사례는 모두 가상 예시입니다. 실제 효과나 작동 원리가 확인되었다는 뜻은 아닙니다.
연구 질문, 가설, 목표, 가정의 차이
Farrugia 등(2010)은 임상·외과 연구의 맥락에서 연구 질문, 가설, 목표를 구분하고 서로 일치하도록 설계할 필요성을 설명합니다.[1] 공학 연구에서도 이 구분은 유용하지만, 모든 연구가 임상시험과 같은 형식을 따르는 것은 아닙니다.
| 구분 | 역할 | 건설 문서 AI의 가상 예시 |
|---|---|---|
| 연구 질문, research question | 무엇을 알아내려는가? | 같은 근거를 제공할 때, 조항 관계를 명시하면 판단 정확도가 높아지는가? |
| 연구 가설, research hypothesis | 어떤 답을 예상하며 왜 그런가? | 관계를 명시하면 조건과 예외의 연결이 쉬워져 정확도가 높아질 것이다. |
| 연구 목표, objective | 연구가 무엇을 달성하려 하는가? | 두 표현 방식을 비교하고, 질문 유형별 오류를 분석한다. |
| 가정, assumption | 설계·분석에서 무엇을 전제로 삼는가? | 제공한 근거가 질문에 답하기에 충분하며 정답 표기가 신뢰할 만하다고 전제한다. |
가정은 편의를 위해 적어두고 잊는 문장이 아닙니다. 타당성을 설명하거나 민감도 분석 등으로 영향을 점검해야 합니다. 한 연구에서 가정으로 둔 내용이 다른 연구에서는 검증할 가설이 될 수도 있습니다.
큰 관심사를 답할 수 있는 질문으로 바꾸기
“LLM이 건설 문서를 잘 해석하는가?”는 아직 넓습니다. 어떤 문서인지, 어떤 질문인지, 무엇과 비교하는지, ‘잘한다’를 무엇으로 판단하는지가 빠져 있습니다.
다음처럼 구체화할 수 있습니다.
건설 시방서의 여러 조항을 결합해야 하는 질문에서, 같은 LLM과 같은 근거를 사용할 때 조항 관계를 명시한 표현은 단순 나열보다 최종 판단 정확도를 높이는가?
여기에는 대상, 비교, 조건, 결과가 들어 있습니다. 실제 연구에서는 질문 집합의 구성과 정답 기준, 관계 표현을 만드는 절차까지 정해야 합니다. 이 문장은 한 가지 설계 예시이지 모든 연구 질문의 필수 문형은 아닙니다.
연구 질문은 반드시 원인을 묻는 “왜?”일 필요도 없습니다. 오류 유형이 얼마나 나타나는지 기술하는 질문, 새로운 현장의 결과를 예측하는 질문, 자원 제약 아래 더 효과적인 방법을 찾는 질문도 가능합니다. 반대로 “프로그램을 개발한다”는 목표만 적으면, 그 개발로 어떤 지식을 얻으려는지는 여전히 남습니다.
가설에는 예상과 이유, 바뀔 가능성이 필요하다
가설의 근거는 이론, 선행연구, 관찰이나 예비 실험에서 나올 수 있습니다. 근거가 약하다면 그 약함을 인정하고 탐색적 질문으로 시작할 수도 있습니다. 방향을 예측하기 어려운데 억지로 “증가할 것이다”라고 쓸 필요는 없습니다.
앞의 RAG 예시에서는 다음을 가설로 둘 수 있습니다.
같은 정보를 제공할 때 조항의 조건·예외 관계를 명시하면, 여러 조항을 결합하는 질문의 판단 정확도가 높아질 것이다.
다만 “관계를 명시한 입력”에 정답을 직접 알려주는 설명이나 추가 정보가 포함된다면, 표현 방식의 효과와 정보량의 효과를 구분하기 어렵습니다. 최종 정답뿐 아니라 조건·예외의 해석과 근거 사용도 평가하면 결과를 이해하는 데 도움이 됩니다.
균열 분할의 예시에서는 다음과 같이 쓸 수 있습니다.
같은 학습자료와 유사한 모델 용량에서, 고해상도 특징을 보존하는 방법은 얇은 균열의 누락을 줄일 것이다.
이때 전체 IoU만 보면 가설을 충분히 평가하기 어려울 수 있습니다. 얇은 균열의 기준, 누락과 오검출의 측정 방법, 모델 용량의 비교 조건을 정해야 합니다.
가설을 적은 뒤에는 어떤 결과가 나오면 이 생각을 수정할 것인지 물어보세요. 관계를 명시해도 개선이 없거나, 추가 정보가 없는 조건에서는 효과가 사라지거나, 더 큰 모델만으로도 같은 결과가 나타날 수 있습니다. 이런 가능성을 미리 떠올리면 실험이 더 분명해집니다.
대안 가설을 구분하는 실험
Platt의 「Strong Inference」(1964)는 대안적인 설명을 세우고, 그 설명들을 구분할 실험을 설계하는 접근을 강조한 고전적인 글입니다.[2] 학생 연구에 적용한다면 “제안한 방법이 잘되는가?”와 함께 “다른 이유로도 이 결과가 나올 수 있는가?”를 묻는 것입니다.
모듈을 제거했을 때 성능이 낮아지는 ablation 결과는, 해당 조건에서 그 모듈의 포함 여부가 결과에 영향을 준다는 근거가 될 수 있습니다. 그러나 그 차이가 논문에서 제안한 내부 작동 원리를 단독으로 입증하지는 않습니다. 표현 방식, 모델 용량, 학습 조건 등 가능한 대안을 구분하는 비교가 필요합니다.
연구 가설과 통계적 가설은 같은가?
연구 가설은 현상이나 방법에 관한 실질적인 주장입니다. 통계적 가설은 선택한 모형 안에서 모집단의 차이, 관계, 분포 등을 수학적으로 표현합니다.
예를 들어 Δ를 관심 대상에서 두 방법의 평균 성능 차이, 즉 ‘제안 방법 − 비교 방법’으로 정의했다고 합시다. 사전에 개선 방향을 검정하기로 정했다면 ‘H₀: Δ ≤ 0, H₁: Δ > 0’처럼 표현할 수 있습니다. 차이의 방향을 정하지 않는 질문이라면 양측 검정이 더 맞을 수 있습니다. 어느 쪽인지는 질문과 분석 계획에 따라 정하며, 결과를 본 뒤 유리한 방향으로 선택하면 안 됩니다.
또한 여러 질문이 같은 문서에 속하거나 여러 영상이 같은 현장에서 나왔다면 관측치가 독립적이라는 전제가 맞지 않을 수 있습니다. 기호를 적는 것만으로 적절한 통계 분석이 되는 것은 아닙니다.
ASA의 p값 성명(Wasserstein & Lazar, 2016)이 설명하듯, p값은 지정한 통계 모형과 귀무가설을 전제로 관측된 검정통계량과 같거나 더 극단적인 값이 나올 확률입니다. 가설이 참일 확률이나 효과의 크기가 아닙니다.[3] 유의하지 않은 결과만으로 두 방법이 동등하다고 결론 내릴 수도 없습니다. 동등성을 주장하려면 실질적으로 허용할 차이와 그에 맞는 분석을 정해야 합니다.
모든 연구에 사전 가설이 필요한 것은 아니다
탐색적 연구는 어떤 현상이 나타나는지 확인하고 이후 검증할 가설을 만들 수 있습니다. 자료 구축, 측정 방법 개발, 설계 연구도 연구 질문과 평가 기준을 갖출 수 있으며, 반드시 방향성 있는 사전 가설로 시작해야 하는 것은 아닙니다. 논문에 RQ1, H1이라는 번호를 붙이는지도 학문 분야와 글의 구조에 따라 달라집니다.
중요한 것은 무엇을 사전에 예상했고 무엇을 결과를 본 뒤 생각했는지 구분하는 일입니다. Kerr(1998)의 HARKing은 결과를 보고 만든 가설을 마치 사전에 세웠던 것처럼 제시하는 문제를 가리킵니다.[4] 결과를 통해 새로운 가설을 만드는 것 자체가 잘못이라는 뜻은 아닙니다.
Nosek 등(2018)은 가설 생성과 검증을 구분하는 방법으로 사전등록을 논의합니다.[5] 연구계획을 적어두는 내부 메모는 유용하지만, 검증 가능한 기록을 남기는 정식 사전등록과 동일하지는 않습니다. 탐색 결과는 탐색으로 보고하고, 이후 별도 자료나 연구에서 확인하는 방식으로 발전시킬 수 있습니다.
다음 미팅 전에 한 장으로 정리하기
다음 다섯 항목이 서로 이어지는지 확인해보세요.
- 질문: 누구 또는 무엇에 대해, 어떤 조건에서, 무엇을 알고 싶은가?
- 예상: 가설이 필요하다면 어떤 답을 예상하며 근거는 무엇인가?
- 비교: 어떤 조건을 비교해야 그 질문에 답할 수 있는가?
- 측정: 어떤 결과를 어떻게 측정할 것인가?
- 판단: 어떤 결과가 나오면 가설을 지지·수정하거나 추가 검토할 것인가?
좋은 가설은 연구자가 원하는 결론을 미리 적은 문장이 아닙니다. 근거가 있으며, 결과에 따라 수정할 수 있고, 실험으로 검토할 수 있는 잠정적인 답입니다.
참고문헌과 읽기 안내
- Farrugia, P., Petrisor, B. A., Farrokhyar, F., & Bhandari, M. (2010). Research questions, hypotheses and objectives. Canadian Journal of Surgery, 53(4), 278–281. 원문
- Platt, J. R. (1964). Strong inference. Science, 146(3642), 347–353. DOI
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA’s statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. DOI
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. DOI
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. DOI
위 문헌의 방법론을 공학 사례에 적용해 설명했습니다. 이 글의 RAG나 균열 인식 가설을 해당 문헌이 직접 검증했다는 뜻은 아닙니다.
그림으로 정리하기
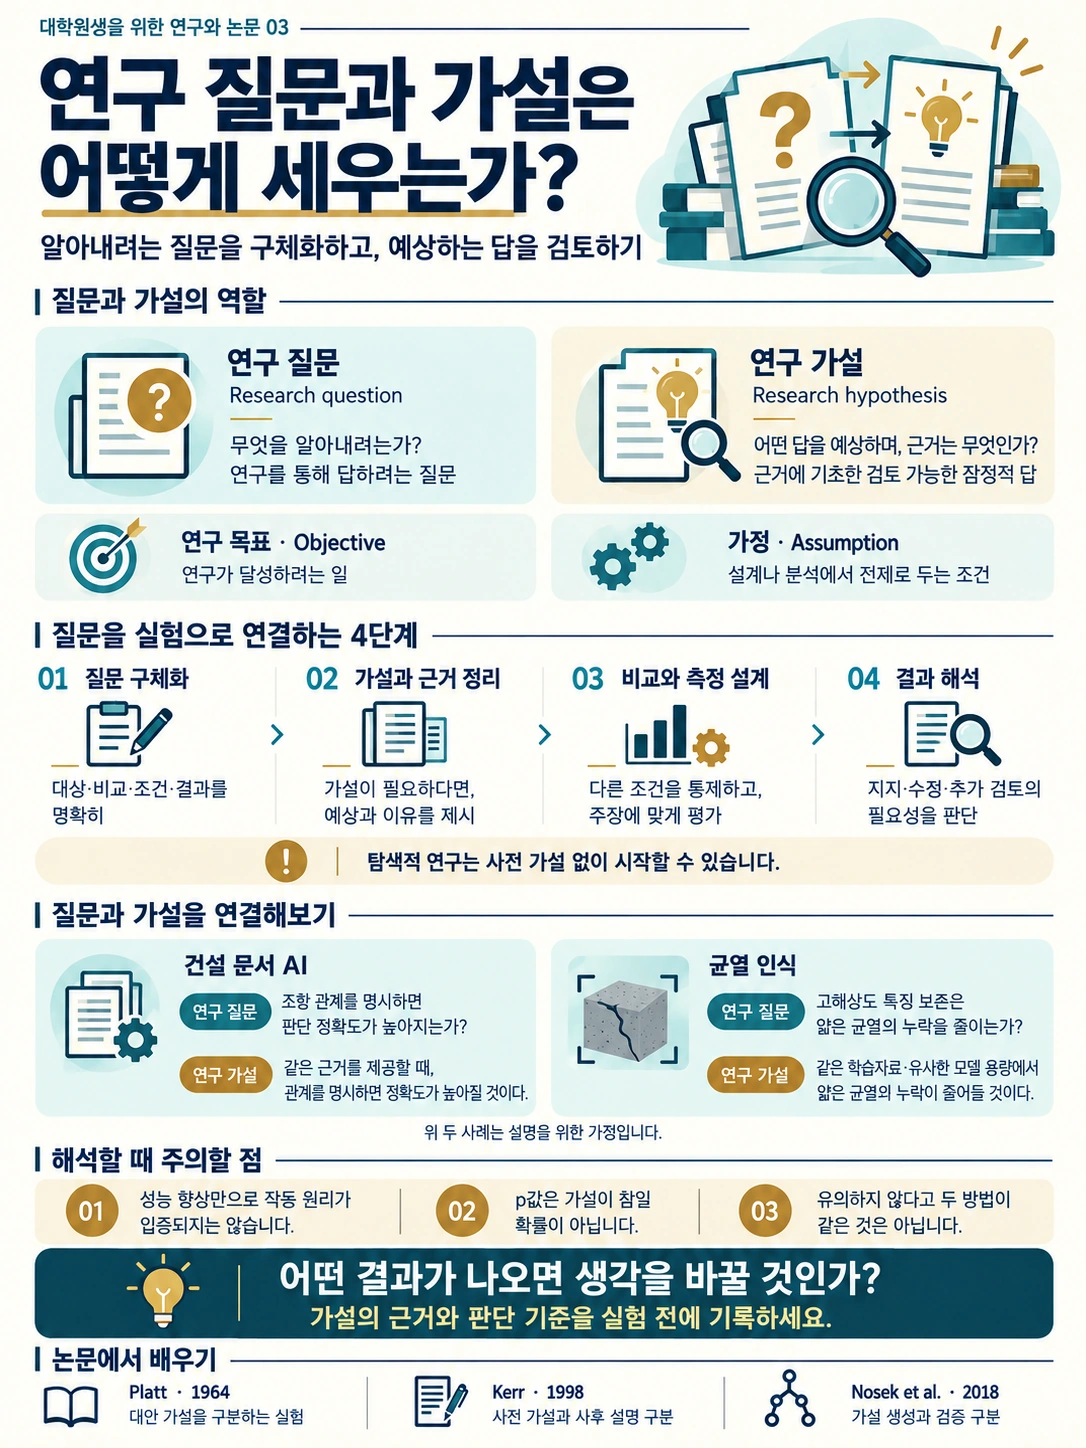
그림을 누르면 확대해 볼 수 있습니다.
대학원생을 위한 연구와 논문 시리즈